Il 15 settembre AWS ha pubblicato un aggiornamento raro per un hyperscaler: dopo mesi di tentativi, non è più in grado di ripristinare l’accesso alle risorse e ai dati rimasti esclusivamente nella Region Middle East (Bahrain), me-south-1.
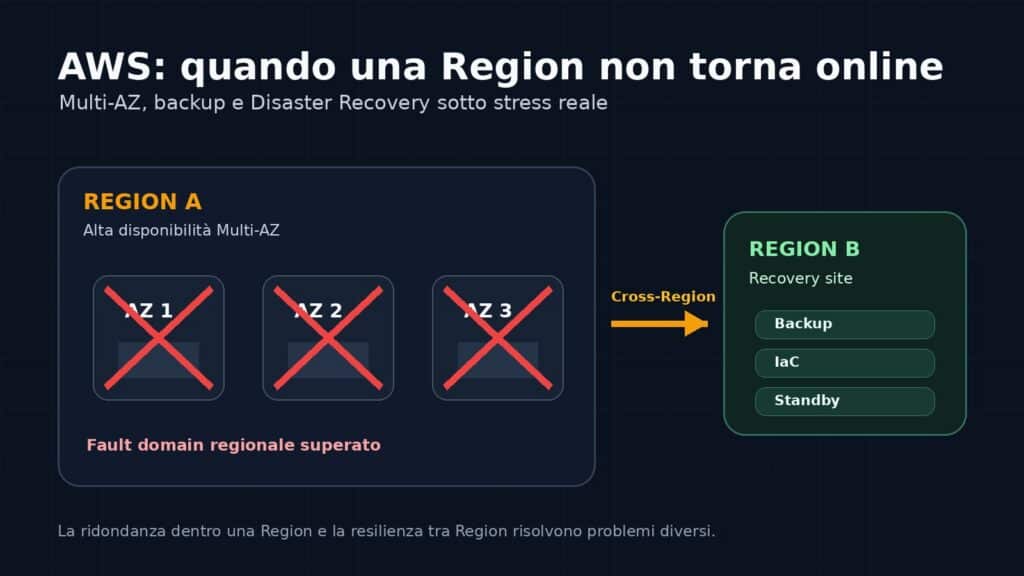
Il danno ha interessato più Availability Zone e, secondo AWS, ha superato ciò per cui i servizi regionali e le architetture Multi-AZ sono progettati. Negli Emirati Arabi Uniti la situazione è diversa ma altrettanto concreta: AWS ha dichiarato non recuperabili le risorse e i dati ospitati esclusivamente nella Availability Zone mec1-az2, mentre continua il lavoro sugli altri componenti della Region me-central-1.
Questa non è una normale storia di downtime. Qui si parla di infrastruttura fisica danneggiata, fault domain superati e dati che, se non erano stati copiati altrove, non sono più accessibili.
Per chi progetta infrastrutture cloud, il caso è utile perché obbliga a separare concetti che spesso vengono messi nello stesso contenitore: alta disponibilità, Multi-AZ, backup e Disaster Recovery.
Cosa è successo davvero
A marzo 2026 AWS ha iniziato a segnalare problemi nella Region UAE. Il primo evento ha interessato mec1-az2. Il giorno successivo AWS ha confermato impatti fisici dovuti a strike con droni su infrastrutture negli Emirati e in Bahrain. Nei report pubblici dell’epoca compaiono danni strutturali, problemi di alimentazione e anche danni da acqua legati alle attività di fire suppression.
Nel momento peggiore, due delle tre Availability Zone della Region UAE risultavano fortemente compromesse. AWS avvertì i clienti che Amazon S3, servizio regionale progettato per tollerare la perdita completa di una singola AZ, stava registrando alti tassi di errore con due AZ indisponibili. Anche EC2, EBS, DynamoDB, Lambda, Kinesis, CloudWatch, RDS, Console e CLI subirono impatti.
In Bahrain il primo danneggiamento di una Availability Zone avvenne a marzo. AWS iniziò a raccomandare ai clienti di spostare i workload verso altre Region. Una seconda Availability Zone fu poi compromessa ad aprile e la Region divenne indisponibile. La maggior parte dei clienti aveva già avviato la migrazione. Per ciò che era rimasto esclusivamente lì, AWS dice di aver esaurito le opzioni di recupero.
Il 15 settembre la posizione è diventata definitiva: AWS non è in grado di ripristinare l’accesso alle risorse e ai dati ospitati esclusivamente in me-south-1. La Region Bahrain ha tre Availability Zone, mes1-az1, mes1-az2 e mes1-az3.
Region e Availability Zone non sono la stessa cosa
Una AWS Region è un fault domain geografico. All’interno contiene più Availability Zone. Ogni AZ è composta da uno o più datacenter con alimentazione, rete e strutture separate dalle altre zone.
Il motivo per cui AWS spinge da anni sul Multi-AZ è semplice: se una zona perde alimentazione, rete o capacità, il workload può continuare a funzionare nelle altre.
È il modello corretto per l’High Availability di moltissimi sistemi.
| Livello | Problema che cerca di assorbire | Esempio |
|---|---|---|
| Singola risorsa | Guasto host, processo o istanza | Auto Scaling sostituisce una EC2 |
| Multi-AZ | Perdita o degrado di una zona | RDS Multi-AZ esegue il failover sulla standby |
| Multi-Region | Region non utilizzabile | Workload ripristinato o promosso in una Region diversa |
| Backup isolato | Perdita, corruzione o compromissione dei dati | Recovery point separato dalla copia di produzione |
Il caso Bahrain ha superato il fault domain previsto per il Multi-AZ. AWS lo dice in modo esplicito: il danno ha attraversato più Availability Zone e ha oltrepassato ciò che i servizi regionali e Multi-AZ sono progettati a sopportare.
Qui sta il confine architetturale. Multi-AZ protegge il workload all’interno della Region. Se il requisito è sopravvivere alla perdita della Region, serve una strategia che porti dati, configurazione e capacità operativa fuori da quella Region.
Multi-AZ non protegge tutti i componenti allo stesso modo
Una delle fonti di confusione è il modo diverso in cui i servizi AWS gestiscono il fault domain.
EC2 ed EBS sono esempi semplici. Un’istanza EC2 vive in una Availability Zone. Anche un volume EBS è zonale. Se quella AZ non è accessibile, la risorsa non può essere semplicemente spostata in un’altra zona. Serve una copia recuperabile, per esempio uno snapshot EBS, e serve capacità compute nella destinazione.
RDS Multi-AZ cambia il problema. Il database ha una replica sincrona in un’altra AZ e AWS può promuoverla in caso di failure della primaria. È una misura molto efficace contro il guasto zonale. Entrambe le copie, però, restano dentro la stessa Region.
Amazon S3 è regionale. Il cliente non sceglie la singola AZ in cui viene conservato un oggetto. Durante l’incidente di marzo AWS ha ricordato che S3 è progettato per continuare a funzionare dopo la perdita completa di una singola Availability Zone. Quando due AZ della Region UAE sono risultate fortemente compromesse, AWS ha segnalato alti tassi di errore in ingest ed egress e ha consigliato ai clienti di inviare i nuovi dati verso un’altra Region.
Anche servizi regionali come Lambda, API Gateway, DynamoDB o molti componenti di controllo dell’applicazione devono essere considerati nel piano. Un database replicato altrove serve a poco se nella Region di recovery non esistono networking, ruoli, secret, image, code, DNS e configurazioni necessari a far partire l’applicazione.
Un backup nella stessa Region condivide ancora parte del rischio
Molte architetture hanno un backup, ma il primo controllo da fare è dove si trova quel backup.
AWS Backup può copiare recovery point in un’altra Region. Gli snapshot EBS possono essere copiati. S3 può usare Cross-Region Replication. Un database può avere repliche o meccanismi di replica cross-Region. Il dettaglio importante è che queste funzioni devono essere configurate prima del disastro.
Se produzione e recovery point dipendono entrambi dalla stessa Region, un evento regionale può rendere indisponibili entrambi nello stesso momento.
C’è poi un secondo problema: replica e backup risolvono problemi diversi.
La replica serve a mantenere una copia aggiornata dei dati e può ridurre molto l’RPO. La stessa velocità può propagare anche una cancellazione, una corruzione logica o un’azione malevola. AWS stessa raccomanda backup point-in-time anche nelle architetture active/active. Il recovery design dovrebbe quindi prevedere sia continuità del dato sia possibilità di tornare a uno stato precedente.
Cross-Region non significa automaticamente Disaster Recovery
Copiarci i dati è solo una parte del lavoro.
Un recovery plan reale deve poter ricostruire lo stack. VPC, subnet, route, security group, load balancer, IAM role, secret, parametri applicativi, certificati, container image, DNS, code e dipendenze devono essere presenti o ricreabili nella Region di recovery.
Qui Infrastructure as Code diventa parte del DR. Se la Region primaria non è disponibile, il team non dovrebbe ricostruire a mano ciò che ricorda dell’ambiente di produzione.
Va considerata anche la capacità. Durante l’incidente di marzo AWS avvertì che l’aumento di domanda sulle Availability Zone rimaste operative poteva allungare i tempi di provisioning o costringere i clienti a scegliere instance type differenti. Lo stesso principio vale per un failover di massa verso un’altra Region. Avere uno snapshot non garantisce che, nel momento peggiore, il numero e il tipo di istanze desiderati siano immediatamente disponibili.
Per workload con RTO stretto, una Region di recovery completamente vuota è quindi una scelta precisa, non un risparmio gratuito.
RTO e RPO decidono quanto costa il DR
AWS usa quattro modelli principali per descrivere il Disaster Recovery.
| Strategia | RPO indicativo | RTO indicativo | Cosa esiste già nella Region DR |
|---|---|---|---|
| Backup & Restore | Ore | Meno di 24 ore | Backup e definizioni necessarie al rebuild |
| Pilot Light | Minuti | Decine di minuti | Core data e componenti minimi sempre attivi |
| Warm Standby | Secondi o minuti | Minuti | Stack completo ma ridimensionato |
| Multi-Region active/active | Vicino a zero | Vicino a zero | Più Region servono traffico contemporaneamente |
I valori sono indicativi e dipendono dal servizio. Il principio è utile: abbassare RTO e RPO richiede che una parte crescente dell’infrastruttura esista già prima dell’incidente.
Con Backup & Restore paghi poco durante il funzionamento ordinario, ma al momento del disastro devi creare risorse, ripristinare dati e riconnettere tutto. Con Warm Standby paghi per mantenere una copia funzionante a capacità ridotta. Con active/active paghi e gestisci due ambienti realmente attivi, oltre alla complessità della sincronizzazione e della consistenza dei dati.
Esempio concreto: un’applicazione a tre tier
Immaginiamo un’applicazione con frontend dietro Application Load Balancer, istanze EC2 su tre AZ, Aurora e file su S3.
Dentro la Region l’architettura sembra molto resistente. Le EC2 sono distribuite, il load balancer usa più AZ, Aurora ha ridondanza, S3 è regionale.
Se una AZ cade, il design ha buone possibilità di continuare a funzionare. È esattamente il problema per cui Multi-AZ è nato.
Se la Region non è più disponibile, la domanda cambia. Dove si trova la copia del database? Esiste un cluster Aurora secondario in un’altra Region oppure bisogna ripristinare uno snapshot? Gli oggetti S3 sono replicati? Le AMI e le container image sono disponibili altrove? I secret sono replicati? Il dominio può spostare traffico? Le quote della Region secondaria sono sufficienti? La pipeline può creare l’ambiente senza leggere artefatti rimasti nella Region primaria?
È possibile avere un’architettura perfettamente Multi-AZ e non avere una risposta soddisfacente a nessuna di queste domande.
Un’architettura DR che considero credibile
Per un workload realmente critico partirei dal business, non dal catalogo AWS. Il proprietario del servizio deve dire quante ore o minuti può restare fermo e quanti dati può perdere. Quelli diventano RTO e RPO verificabili.
Da lì sceglierei una recovery Region e porterei fuori dalla primaria tutto ciò che serve per ricostruire il servizio: backup dei dati, definizioni IaC, artefatti applicativi e configurazioni. Per i database con RPO stretto userei replica cross-Region coerente con il servizio scelto. Aurora Global Database, per esempio, permette failover cross-Region con RPO tipicamente nell’ordine dei secondi, a fronte di replica asincrona e costi maggiori.
Per i backup valuterei anche separazione di account e controlli di immutabilità. Un evento fisico e un ransomware sono failure mode diversi, ma un buon recovery design dovrebbe evitare che la stessa credenziale o lo stesso errore amministrativo possa eliminare sia la produzione sia le copie di recupero.
Infine farei test periodici. Un backup “Completed” dimostra che un job ha scritto un recovery point. Non dimostra che l’applicazione possa tornare online entro l’RTO dichiarato.
La conseguenza reale del caso Bahrain
Questo episodio non dimostra che il modello AWS Multi-AZ sia sbagliato. Mostra il suo perimetro.
Le Availability Zone sono progettate per isolare molti guasti fisici e operativi all’interno di una Region. AWS stessa dice che, per la maggior parte dei workload, una buona architettura Multi-AZ in una singola Region è sufficiente. Multi-Region aumenta costo e complessità e va deciso in base ai requisiti.
Il problema nasce quando un’azienda assegna al Multi-AZ un requisito che appartiene al Disaster Recovery regionale.
La domanda che farei oggi durante un architecture review è questa: se domani la Region primaria diventasse completamente inutilizzabile, quali dati esistono già fuori da quella Region e quanto tempo servirebbe davvero per tornare a servire traffico?
Se la risposta è “abbiamo tre Availability Zone”, stiamo rispondendo a un’altra domanda.